Python Pandas
Pandas介绍
Pandas 是 Python 中用于结构化数据处理与分析的核心第三方库,广泛应用于数据分析、商业智能和数据工程领域。
核心优势
- 高性能:底层基于
NumPy,支持快速向量化运算; - 缺失值处理:提供完善的 API(如
fillna,dropna); - 灵活的数据操作:强大的分组(
groupby)、聚合(agg)与转换(transform)能力。
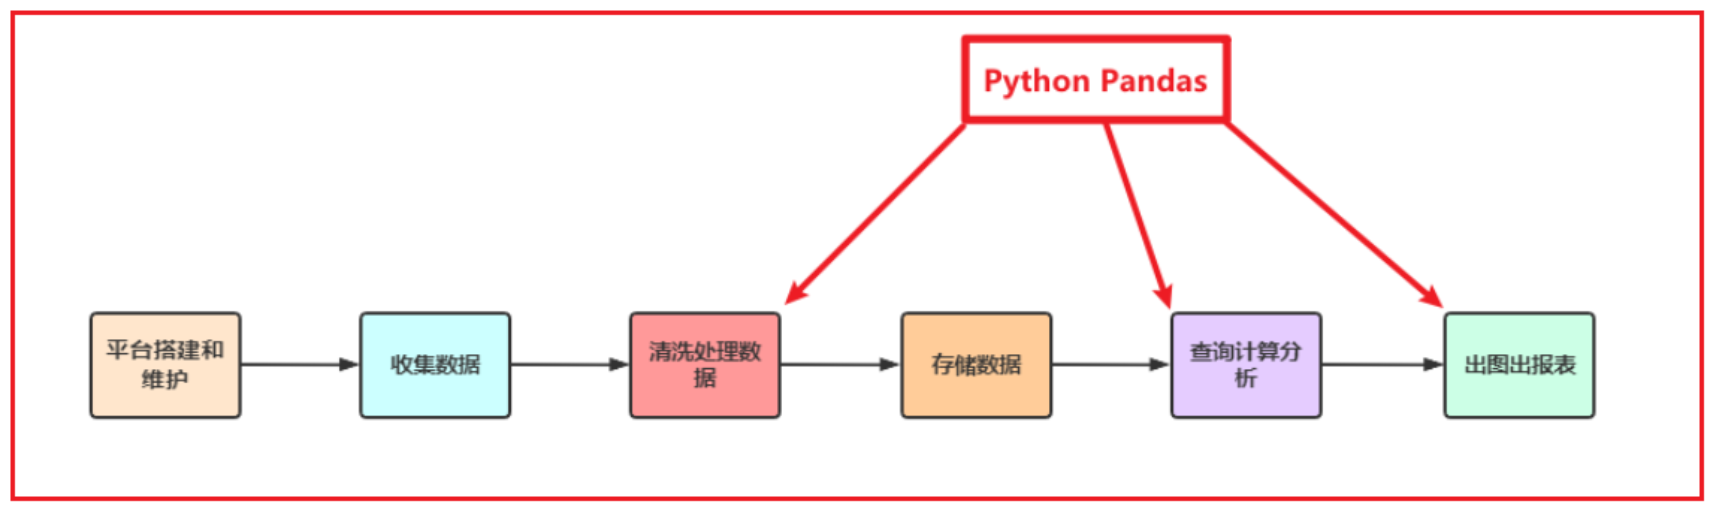
典型适用场景
- 单机中等规模数据(GB 级):当 Excel 性能不足时,Pandas 是理想替代;
- ETL 流程中的数据清洗:在大数据 pipeline 前端,常用于数据预处理与质量治理。
Pandas 基本使用
import pandas as pd
# 数据导入
df = pd.read_csv('路径', encoding) # 默认查看前十条数据
df.head()  # 查看头部数据(默认前五条)

# 读取特定数值的数据 -> 返回 字段名=='字段值' 的数据
df[df.字段名=='字段值']

# 将某字段设置为索引列
df.set_index('字段名')

# 绘制变化曲线(所有数值),每一组数据都绘制一张图
df.plot()  # 需要先安装 matplotlib

# 根据某字段的数值绘制变化曲线,可将同字段的不同组的数据绘制到一张图
df.字段名.plot()

# 图例名设为中文
# 1. 解决中文显示问题,下面的代码只需运行一次即可
import matplotlib as plt
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False

# 2. 将字段名重名为中文
df.rename(columns={'字段名':'新字段名'}, inplace=True)  # inplace=True 修改原数据

# 3. 绘制带有图例的曲线图(修改曲线颜色)
df.字段名.plot([color, legend=True])  # legend=True 增加图例
Pandas 的数据结构与数据类型
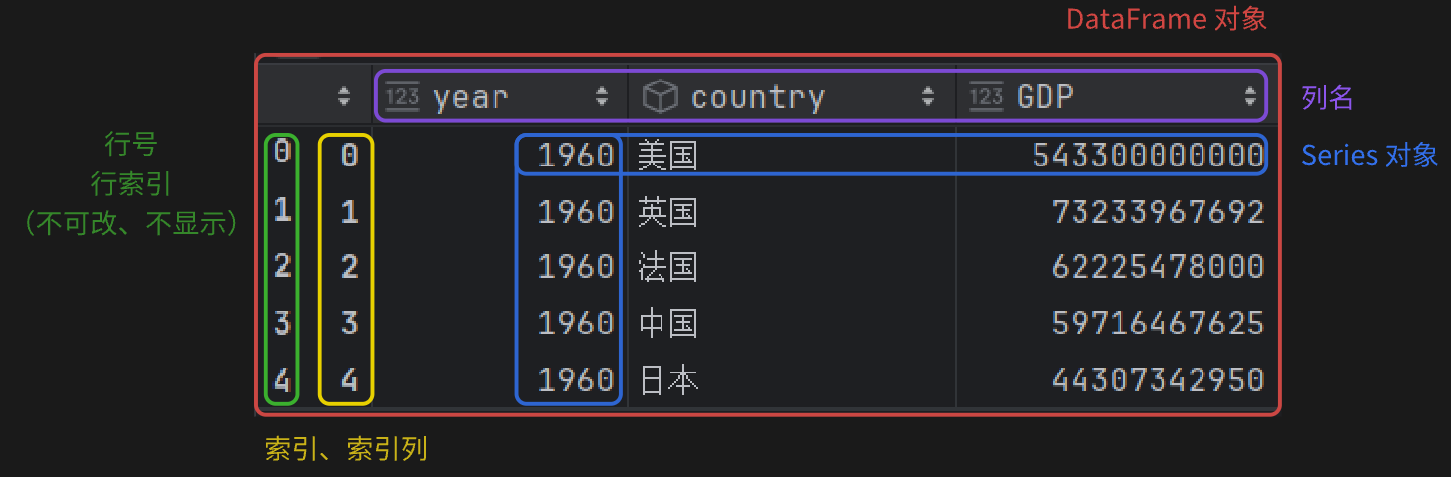
Pandas 的数据结构
DataFrame
	Series
	- 索引列
	  - 索引名、索引值
	  - 索引下标、行号
	- 数据列
	  - 列名
	  - 列值,具体的数据
DataFrame
定义:二维表格型数据结构,由多个 Series 共享同一索引构成
结构:
- 行索引(index):标识每一行(可命名);
- 列(columns):每列是一个 Series,具有列名和数据。
Series
定义:一维带标签的数组,是 Pandas 最基本的数据结构
由两个部分组成:
values和indexSeries index value 0 12 1 3 2 654 3 45 values:实际数据,底层为numpy.ndarrayindex:与数据对齐的标签(索引),默认为 RangeIndex(0, N)(整数 0 到 N-1,数据长度为N)
关系:
DataFrame≈ 多个同索引的Series横向拼接;Series≈ 带标签的一维数组(index+values)
Pandas 的数据类型
| Pandas 数据类型 | 说明 | 对应的Python类型 |
|---|---|---|
| Object | 字符串类型 | string |
| int | 整数类型 | int |
| float | 浮点数类型 | float |
| datetime | 日期时间类型 | datetime包中的datetime类型 |
| timedelta | 时间差类型 | datetime包中的timedelta类型 |
| category | 分类类型 | 无原生类型,可以自定义 |
| bool | 布尔类型 | bool (True,False) |
| nan | 空值类型 | None |
查看
series对象或dataframe对象中数据的类型pythons.dtypes df.dtypes df.info()category类型用于表示分类数据,优点:占用更少的内存,且对分类数据的操作更快
Series对象
创建 Series对象
通过 list 创建
pythonpd.Series(list) # 索引从零开始 pd.Series(list, index=['a','b']) # 指定索引通过 tuple 创建
pythonpd.Series(tuple)通过 dict 创建
pythonpd.Series(dict) # key:索引,value:数据通过 numpy 创建
pythonarr = np.arange(10) pd.Series(arr)
Series对象 属性
s = pd.Series(arr)
s.index   # 获取索引列的值
s.values  # 获取数值列

# 通过索引获取对应的值
s[0]  			  # 通过位置
s['index_value']  # 通过标签
DataFrame对象
创建 DataFrame对象
通过
dict + list/tuple创建(默认自增索引)pythondata_dict = { 'key1': [], ... } df = pd.DataFrame(data=data_dict [,index])通过
list + tuple/list创建(自定义列名)pythondata_list = [ (value,), ... ] df = pd.DataFrame(data=data_list ,columns=[] [,index])通过
numpy数组创建(自定义列名和索引)pythonarr = np.random.randint(low, high, size) pd.DataFrame(arr, columns=[] ,index=[])
DataFrame对象 属性
df.shape  	# 获取维度大小(行数,列数)
df.index  	# 获取索引列(行索引)
df.columns  # 获取所有的列名
df.values   # 获取所有的数值
df.T      	# 转置,行列转置
df.size 	# 获取元素个数(即:行数*列数)
df.dtypes	# 获取每一列的数据类型
DataFrame对象 方法
df.head()  # 显示前 n行数据(默认前五行)
df.tail()  # 显示后 n行数据(默认后五行)
df.describe()  # 获取数据的描述性 统计信息(总数、平均值、标准差、最小值...)
df.info()  # 获取数据的描述性 详细信息(class、index、colums...)
df.drop(colums=['列名'] 	# 删除列
df.drop(index=['索引名']	# 删除行
df.drop([''], axis)  # 旧版删除行列(0-行,1-列)
DatatFrame 索引的设置
修改索引值
pythondf.index = 新索引 # 索引必须整体修改将某列值设置为新的索引
pythondf.set_index(keys [,drop, inplace]) # - keys:列索引名 或 列索引名称的列表 # - drop: 是否从数据列中删除该列 # - True 删除原来的索引值(默认) # - False 原索引列 -> 普通数据列 df.set_index('列名'] # 设置单个索引列 df.set_index(['列名1','列名2']) # 设置多个索引列重设索引
pythondf.reset_index([drop, inplace]) # - drop: 原行索引是否作为新列加入 # - False 原索引变为列'index'或原索引名(默认) # - True 删除原行索引,用默认 RangeIndex(0, 1, 2...)
Pandas 基础运算
算法运算
'''每行列值 +1'''
# 临时修改
df['col'] + 1
df['col'].add(1)
# 修改原数据
df['col'] += 1

'''每行列值 -1'''
df.列名 - 1
df.列名.sub(1)
df.列名 -= 1

'''dataframe 所有数值 +1'''
df + 1
df.add(1)
df += 1  # 原地修改

'''series和series 运算'''
df.列名1 + df.列名2   # 对应元素进行计算,不匹配的用NaN填充
s1.add(s2, fill_value=0)  # 用 fill_value 填充缺失(避免 NaN)

'''dataframe和dataframe 运算'''
df1 + df2   # 对应元素进行计算,不匹配的用NaN填充
df1.add(df2, fill_value=0)  # 用 fill_value 填充缺失
逻辑运算
逻辑运算符
python# 条件表达式返回: 布尔 Series s > 0 df['列名'] > 0 # 筛选并查看结果 df[df['列名'] > 0].head() # 多条件组合 df[(df['列名'] > 0) & (d['列名'] < 1)].head()query()pythondf.query(expr) # 字符串表达式筛选 # 基础用法:使用列名直接写条件(类似 SQL) df.query('A > 0 and B < 5') # 成员判断 df.query('city in ["Beijing", "Shanghai"]') # 引用外部变量(必须加 @) threshold = 10 df.query('score > @threshold') # 处理含空格/特殊字符的列名(用反引号) df.query('`GDP ($)` > 1000')isin()pythondf['列名'].isin(values) # 成员资格判断 # 判断 Series 元素是否在 values 中 df['city'].isin(['Beijing', 'Shanghai']) # 返回布尔 Series # 用于行筛选 df[df['city'].isin(['Beijing', 'Shanghai'])] # 支持多种 values 类型 df['col'].isin({1, 2, 3}) # set(推荐,去重且高效) df['col'].isin([1, 2, 3]) # list df['col'].isin((1, 2, 3)) # tuple df['col'].isin(pd.Series([1,2])) # Seriespython# 判断整个 DataFrame 元素是否在 values 中 df.isin([1, 2, 3])
统计运算
describe()
pythondata.describe() # 结果:count、mean、std、min、25%、50%、75%、max统计函数
函数 介绍 countNumber of non-NA observations sumSum of values meanMean of values medianArithmetic median of values minMinimum maxMaximum modeMode(众数) absAbsolute Value(绝对值) prodProduct of values(乘积) stdBessel-corrected sample standard deviation(标准差:方差开根号) varUnbiased variance(无偏方差) idxmaxcompute the index labels with the maximum(最大值的位置) idxmincompute the index labels with the minimum(最小值的位置) count()pythondf.count() df.count(axis='index') # 按列统计(默认) df.count(axis='columns') # 按行统计 # 0-index, 1-columns df.count(axis='rows') # (不推荐)实际触发 axis=1idxmax()python【注】比较值需为int类型 # 找每列最大值所在的行索引 df.idxmax(axis=0) # 或 axis='index' # 找每行最大值所在的列名 df.idxmax(axis=1) # 或 axis='columns'
累计统计函数
| 函数 | 作用 |
|---|---|
cumsum | 计算前1/2/3/…/n个数的和 |
cummax | 计算前1/2/3/…/n个数的最大值 |
cummin | 计算前1/2/3/…/n个数的最小值 |
cumprod | 计算前1/2/3/…/n个数的积 |
cumsum()pythondf.cumsum() # 计算每列的累加和 df['列名'].cumsum() # 计算指定列的累加和
apply() 自定义运算
df.apply(func, axis=0)  # axis=0:传入该列的 series

df.apply(lambda col: col.max(), axis=0)  # 每列最大值
df.apply(lambda row: row.sum(), axis=1)  # 每行求和
文件读取与存储
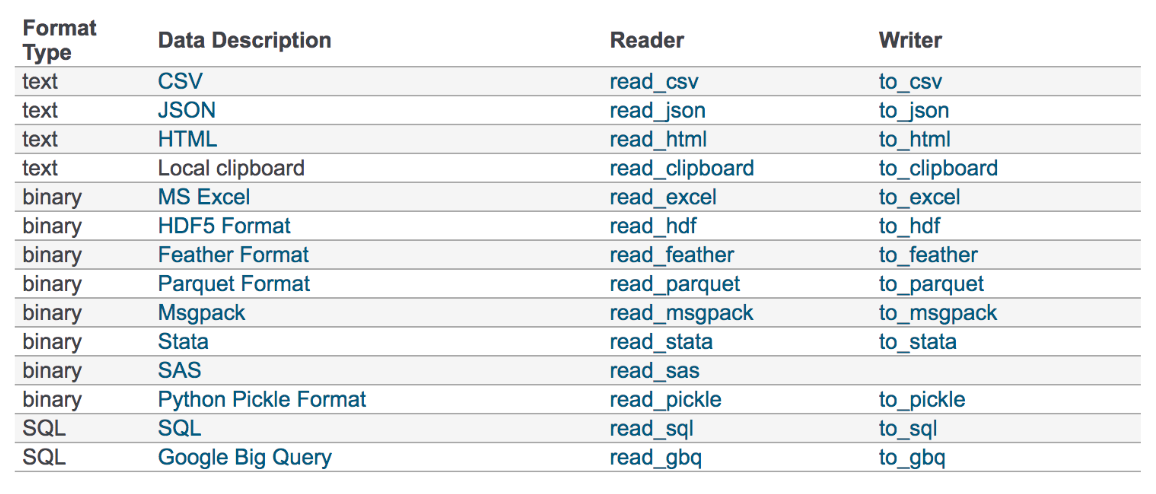
read_csv()pythonpd.read_csv(filepath_or_buffer, sep =',', usecols=[]) # filepath_or_buffer: 文件路径 # sep: 分隔符,默认用","隔开 # usecols: 指定读取的列名,列表形式 # index_col: 将某列设置为 索引列 # 读tsv文件 pd.read_csv(path,sep='\t') # 需要使用 \t 隔开to_csv()pythondf.to_csv( path_or_buf, # 文件路径 sep=', ', # 分隔符,默认:“,” columns=[], # 选择需要写入的列 header=True, # 是否需要显示 header信息(列名) index=True, # 是否写入索引 mode='w', # 模式:w-重写,a-追加 encoding=None # 编码格式 ) # 写tsv文件 df.to_csv(path,sep='\t') # 需要使用 \t 隔开read_json()pythonpd.read_json( path_or_buf=, orient, typ='frame', lines=False )to_json()pythondf.to_json( path_or_buf, orient, lines=False )
DataFrame 的增删改查
DataFrame 增加列
通过赋值的方式
python# 会修改原数据 df['new col'] = 1 df['new col'] = [1,2,3,4] # 列数据数量需要和行数相等 df['new col'] = 表达式 # 可以使用其他列的值来计算assign()python# 不改变原数据,可同时增加多个列 df.assign(new_col=1) df.assign(new_col=[1,2,3,4]) df.assign( new_col1=表达式, new_col1=serise对象, new_col1=func, # func(df),df为调用assign的df对象 )
DataFrame 删除列
drop()pythondf.drop([0]) # 删除行(默认) df.drop(['col'], axis=1) # 删除列 df.drop([0, 2, 4]) # 删除多行 df['列名'].drop([0, 2]) # 对series对象,按索引删除delpythondel df['col']
【区别】drop() 和 del
- del是直接永久删除原df中的列【慎重使用】
- drop是返回删除后的df或seires,原df或seires没有被修改
DataFrame 数据去重
drop_duplicates()pythondf.drop_duplicates() df.列名.drop_duplicates()unique()pythondf.列名.unique() # 返回 array
DataFrame 数据修改
assign()pythondf.assign(列名=1) # 返回:新的 dataframe对象 df.assign(列名=[]) df.assign(列名=array)replace()pythondf.列名.replace(原数据, 新数据 [,inplace]) # inplace=True 直接修改原数据 df.replace(原数据, 新数据) # 多值替换 df.replace(['旧数据1','旧数据2'], ['新数据1','新数据2']) df.replace({'旧数据1':'新数据1','旧数据2':'新数据2'})赋值修改
pythondf['列名'] = [5, 4, 3, 2, 1] # 直接修改原数据 df.列名 = 值 # 有空格、数字开头或特殊符号时,不能使用 【注】若列不存在则自动添加并赋值,即:新增列
DataFrame 数据查询
根据行列索引,获取数据
pythondf[colums][index]head()pythondf.head() # 获取前5行数据(默认)tail()pythondf.tail() # 获取后5行数据(默认)通过索引标签获取数据
pythondf['列名'] # 返回 Series df.列名 # 仅当列名为合法 Python 标识符时可用 df[['列1', '列2']] # 返回 DataFrame(多列)通过索引获取数据
python# 根据索引‘标签’获取数据 df.loc['index1':'index2', '列名'] # 某列中从 index1~index2 的数据 # 根据索引‘下标’获取数据 df.iloc[:3,:5] # 获取前三行,前五列的数据 # 通过切片获取数据 df[start:stop:step] # 获取某行数据,顾头不顾尾 df[0:3] # 按位置切片 df['a':'c'] # 按标签切片query()
pythondf.query('列名=="值"') # 效果相同 df.query('列名1=="值1" or 列名1=="值2" or 列名1=="值3"').query('列名2 in [1,2,3]') df.query('列名1 in ["值1","值2","值3"] and 列名2 in [1,2,3]')
排序函数
sort_index()和sort_values()python'''根据列值进行排序''' s.sort_values() df.sort_values( by, # 必填!列名(str)或列名列表(list),指定按哪些列的值排序 axis=0, # 排序轴:0 按行排序(默认),1 按列排序(较少用) ascending=True, # 升序/降序:单列时为 bool,多列时可为 bool 列表(如 [True, False]) inplace=False, # 是否原地修改 kind='quicksort',# 排序算法(同 sort_index) na_position='last', # NaN 值位置:'first' 或 'last'(默认) ignore_index=False, # 是否重置索引为 0,1,2,... key=None # 对 `by` 指定的列应用转换函数后再排序,如 key=lambda col: col.str.len() ) # 根据多列的值进行排序,且进行升序排序后,相同值再进行降序排序 df.sort_values(['列名1','列名2'] ,ascending=[True,False])python'''根据索引进行排序''' s.sort_index() df.sort_index( axis=0, # 排序轴:0 按行索引(index)排序,1 按列索引(columns)排序 level=None, # 若索引是 MultiIndex,指定按哪一层排序(可为整数或名称) ascending=True, # 升序(True,默认)或降序(False) inplace=False, # 是否原地修改 DataFrame(默认返回新对象) kind='quicksort',# 排序算法:'quicksort'(默认)、'mergesort'、'heapsort'、'stable' # 注意:'mergesort' 和 'stable' 是唯一支持稳定排序的选项 na_position='last', # NaN 索引的位置:'first'(放最前)或 'last'(放最后,默认) sort_remaining=True, # 仅用于 MultiIndex:是否在指定 level 后继续对剩余 level 排序 ignore_index=False, # (pandas ≥1.0)是否忽略原索引,重置为 0,1,2,... key=None # (pandas ≥1.1)可传入函数对索引进行转换后再排序,如 key=lambda x: x.str.lower() )rank()pythons.rank() df.rank( axis=0, # 排名方向:0 对每列分别排名(默认),1 对每行分别排名 numeric_only=False, # 是否仅对数值型列排名;False 时包含可排序的非数值列 na_option='keep', # NaN 处理方式:,keep/top/bottom # - keep: 保留 NaN 位置 # - top: NaN 排最前 # - bottom: NaN 排最后 ascending='True', # 升序(True)/降序(False) pct=False, # 是否以排名的百分比显示排名 method='average', # 处理相同值的排名方式:average/min/max/dense # - 'average': 平均排名(如 2.5) # - 'min' : 取最小排名(后续跳过) # - 'max' : 取最大排名(后续跳过) # - 'dense' : 最小排名,但后续不跳过(排名连续)【重点】 )
处理-缺失值NAN
判断是否存在 NaN
df.info()      # 查看详细信息,其中包含每列非空计数和类型
df.isnull()    # 判断数据是否 为空,NaN 位置为 True
df.notnull()   # 判断数据是否 不为空,非 NaN 位置为 True
df.isnull().sum()  	# 每列 NaN 数量
df.notnull().sum()  # 每列非 NaN 数量

# 判断整个 DataFrame 是否完全无缺失值
not df.isnull().any().any()   	# True 表示无任何 NaN
np.all(pd.notnull(df) == True)  # True 表示无任何 NaN
处理NaN
dropna()删除NaNpythondropna( axis=0, # 0/'index':删除包含 NaN 的行(默认);1/'columns':删除包含 NaN 的列 how='any', # 删除条件:'any'(任一 NaN 即删,默认),'all'(全为 NaN 才删) thresh=None, # 保留行/列所需的最小非 NaN 值数量,与 how 互斥 subset=None, # 指定在哪些列(axis=0 时)或行(axis=1 时)中检查 NaN inplace=False, # 是否原地修改(默认返回新对象) ignore_index=False # 是否重置索引为 0,1,2,...(默认保留原索引) )fillna()填充NaNpythonfillna( value=None, # 填充值(标量、字典、Series 等)— 通常需提供(逻辑上必填) axis=None, # 填充方向(配合 method 使用,现基本不用) inplace=False, # 是否原地修改 limit=None, # 最多连续填充多少个 NaN(配合 method,现少用) downcast=None # (高级)数据类型降级控制,一般忽略 ) # 用每一列的平均值,替换每一列的缺失值 # 方式一: df = df.fillna(df.select_dtypes(include=[np.number]).mean()) # 方式二: for i in df.columns: if np.all(pd.notnull(df[i])) == False: print(i) df[i].fillna(df[i].mean(), inplace=True)缺失值没有使用
NaN标记,比如使用"?"先替换‘?’为np.nan,然后继续处理
pythonwis = wis.replace('?', np.nan) # 先转为标准 NaN wis = wis.dropna() # 再按标准流程处理
数据合并
concat()按照行或列进行合并pythonpd.concat([data1, data2] [, axis=0]) pd.concat( objs, # 必填!要合并的对象列表(如 [df1, df2, df3] 或 [s1, s2]) axis=0, # 合并轴:0 按行拼接(上下堆叠,默认);1 按列拼接(左右并排) join='outer', # 列/行标签的对齐方式: # - 'outer':取并集(默认),缺失处填 NaN # - 'inner':取交集,只保留共有的列(axis=0 时)或行(axis=1 时) ignore_index=False, # 是否忽略原索引,重置为 0,1,2,...(默认 False,保留原索引) keys=None, # 为每个输入对象添加层级索引(用于区分来源),生成 MultiIndex sort=False, # 当 join='outer' 且列顺序不一致时,是否对结果列排序(默认 False) copy=True # 是否强制复制数据(未来版本可能默认为 False,一般可忽略) )merge()根据两组数据的共同键值对,按关系型数据库的“表连接”(join)方式进行合并pythonpd.merge(left, right [,how='inner' , on=None]) pd.merge( left, # 左侧 DataFrame(必填) right, # 右侧 DataFrame(必填) how='inner', # 连接方式: # - 'inner':内连接(默认),仅保留两表共有的键 # - 'outer':外连接,保留所有键,缺失处填 NaN # - 'left' :左连接,保留 left 所有行 # - 'right':右连接,保留 right 所有行 on=None, # 用于连接的列名(必须在两个表中都存在) # - 若未指定,则自动使用两个表的共有列作为连接键 left_on=None, # left 表中用于连接的列名(当左右连接列名不同时使用) right_on=None, # right 表中用于连接的列名(配合 left_on 使用) left_index=False,# 是否使用 left 的索引作为连接键 right_index=False,# 是否使用 right 的索引作为连接键 sort=False, # 是否按连接键对结果排序(默认 False,性能更优) suffixes=('_x', '_y'), # 当左右表有同名列(非连接键)时,添加后缀区分 copy=True, # 是否复制数据(一般可忽略) indicator=False, # 是否添加一列 _merge,标明每行来源('both', 'left_only', 'right_only') validate=None # 验证连接类型(如 'one_to_one', 'one_to_many' 等,用于调试) )
数据分组
数据分组 & 提取分组数据
groupby()返回
GroupBy对象,需配合聚合/转换方法使用pythondf.groupby(['列名1','列名2'] [,axis=0]) # 返回 DataFrameGroupBy 对象 df.groupby('列名1')['列名2'] # 返回 SeriesGroupBy 对象 df.groupby( by, # 分组依据(必填): # - 单列名(str):如 'category' # - 多列名(list):如 ['col1', 'col2'] # - Series / 函数 / 字典:用于自定义分组规则 # - 列位置(int)或索引(仅当 axis=1 时) axis=0, # 分组轴:0 按行分组(默认,即对行按某列分组);1 按列分组(较少用) level=None, # 若索引是 MultiIndex,指定按哪一层分组(整数或名称) as_index=True, # 是否将分组列作为结果的索引(True 默认); # False 时,分组列保留在列中(类似 SQL GROUP BY 后 SELECT) sort=True, # 是否对分组键排序(默认 True);设为 False 可提升性能 group_keys=True, # 在 apply 或 transform 时是否保留分组键(一般保持默认) observed=False, # 对 Categorical 类型:True 表示只显示出现过的类别(节省内存) dropna=True # 是否排除 NaN 值所在的组(pandas ≥1.1,默认 True) )get_group()从分组结果中提取指定组的数据
pythongrouped.get_group( name # 要提取的组标签(必填): # - 单层分组:传入单个值,如 'A' # - 多层分组(MultiIndex):传入元组,如 ('A', 'X') ) # grouped:对 DataFrame/Series 执行 .groupby(...) 得到 grouped 对象分组中的
first()和last()pythongs.first() # 取出每组第一条(非NaN)数据 gs.last() # 取出每组最后一条(非NaN)数据
分组聚合
方式一:groupby() + 聚合函数
链式方式
python# 以下效果一致 df.groupby('列名1').列名2.sum() df.groupby('列名1').列名2.agg('sum'}) df.groupby('列名1').agg({'列名2':'sum'})agg()pythongrouped.agg( func=None, # 聚合函数(可为 str / function / list / dict): # - 字符串:'sum', 'mean', 'count', 'std' 等内置函数名 # - 函数:np.mean, len, lambda x: x.max() - x.min() # - 列表:['min', 'max'] → 对每列计算多个统计量 # - 字典:{'col1': 'mean', 'col2': ['sum', 'count']}(推荐用于多列不同聚合) axis=lib.no_default, # 已弃用或内部使用,一般忽略 *args, **kwargs # 传递给聚合函数的额外参数(如 lambda 中的参数) ) # 按城市和线上线下划分,分别计算销售金额的平均值、成本的总和 df.groupby(['city', 'channel']).agg({ 'revenue':'mean', 'unit_cost':'sum' }) # 自定义聚合 df.groupby('dept').agg(lambda x: x.max() - x.min())
方式二:透视表
pivot_table()pythondf.pivot_table() df.pivot_table( values=None, # 要聚合的数值列(可为 str 或 list);若未指定,则使用所有数值列 index=None, # 行分组键(可为 str / list / array)— 对应透视表的“行标签” columns=None, # 列分组键(可为 str / list / array)— 对应透视表的“列标签” aggfunc='mean', # 聚合函数:'mean'(默认)、'sum'、'count'、len、np.max 等; # 也可为字典:{'col1': 'sum', 'col2': 'mean'} fill_value=None, # 用于填充结果中缺失值(NaN)的值,如 0 margins=False, # 是否添加“总计”行/列(如行总计、列总计) dropna=True, # 是否排除包含 NaN 的分组(默认 True) margins_name='All', # 总计行/列的名称(默认 'All'),需 margins=True 才生效 observed=False, # 对 Categorical 类型:True 表示只显示出现过的类别 sort=True # 是否对分组键排序(默认 True) )
分组过滤
filter()pythongrouped.filter( func, # 必填!过滤函数(接受一个子 DataFrame/Series,返回 bool): # - 返回 True:保留该组所有行 # - 返回 False:丢弃该组所有行 dropna=True # 是否在调用 func 前移除 NaN(一般保持默认) ) # 保留组内行数 ≥ 3 的组 df.groupby('team').filter(lambda x: len(x) >= 3)先过滤再聚合
pythondf.groupby('A').filter(...).groupby('A').agg(...) # 需重新 groupby
相关笔记
- Python NumPy - NumPy 是 Pandas 的底层依赖,数值计算基础
- Python Matplotlib - Pandas 数据可视化常结合 Matplotlib
- 数据分析概览 - 数据分析技术栈全景